语义输入法 vs 实时听写:Typeless 的思考缓冲区怎么实现
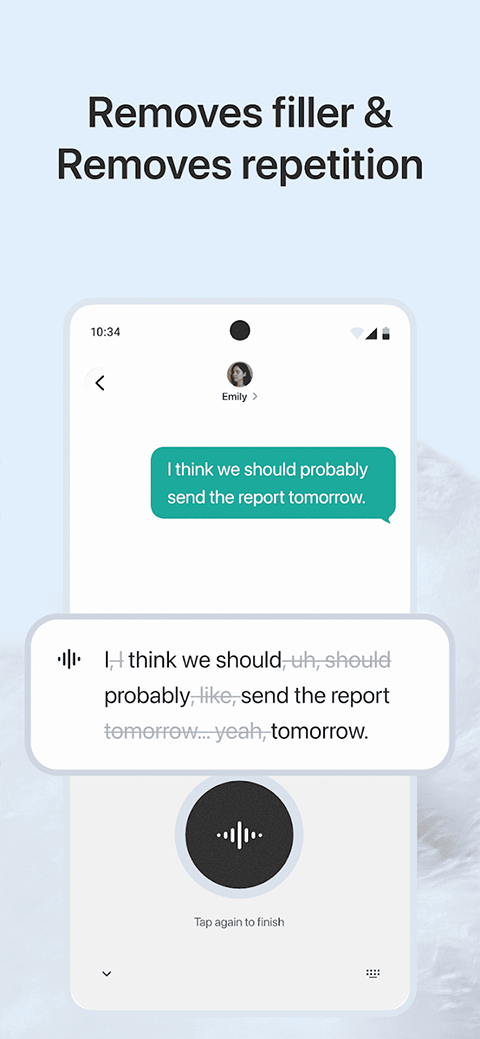
用过实时听写的人都知道那种别扭:你得一边说一边想着"这句话说完没?标点在哪?下一句要不要换行?"——不然屏幕上就是一坨密密麻麻的字,改起来比打字还累。Typeless 反过来,它给你一个思考缓冲区:你可以先把脑子里的东西倒出来,不必担心措辞和结构,哪怕前半段说错了、后半段补回来,它也能把整段内容整合成一个完整的意思。
三步成稿流程
Typeless 的后台处理逻辑可以概括为三步:
- 收集音频:你按下 Speak 开口,它开始录音——不是边录边转,而是纯收集。
- 语义解析:松开按键后,音频送云端处理。大模型不只做语音识别,还理解你这段话的语义——哪些是口头禅("嗯"、"那个"、"就是说"),哪些是改口("不对,应该是"后面那部分覆盖前面),哪些是数字金额、专有名词需要格式化。
- 成稿输出:理解完成后,输出一份整理过的文字稿——语气词消失了、改口只留最终版本、列表排成编号列表、邮件自动加称呼落款。
4 倍速是怎么算的
typeless.com 公开的对比数据是 220 wpm(Typeless)vs 36 wpm(QWERTY 键盘打字),约 6 倍差距——但这个数字是英文环境下的。中文口述速度因人而异,通常在每分钟 150 到 250 字之间,打字速度在每分钟 60 到 100 字之间,实际差距在 2 到 4 倍左右。
无论具体数字是多少,体验上的差距比纯速度数字更大——因为打字时你是"拇指追赶思路",嘴早就把话说完了;Typeless 把这个追赶关系反过来,让思路跑得比手快。
代价是什么
这个"先说完再整理"的路径当然有取舍:
- 需要联网:语义处理在云端完成,断网或弱网时出不来高质量成稿。
- 有几秒延迟:和实时出字不同,Typeless 是"按一下 → 说完 → 再按一下 → 等几秒 → 文字出来"。
- 单次有上限:最长 9 分钟,第 8 分钟会有倒计时提醒。
这些取舍对需要"逐字同步实时展示"的场景(比如直播字幕、实时会议记录)可能是硬伤,但对绝大多数日常输入场景——写消息、写邮件、写文档、写代码注释——完全够用,甚至体验更好。
接下来看怎么在手机和电脑上装好。